Spring 数据集成演进简史
Spring 在数据集成领域的探索始于 Spring Integration。通过其编程模型,它为构建能够采用企业集成模式来连接数据库、消息代理等外部系统的应用程序,提供了一致的开发者体验。
快进到云时代,微服务在企业环境中变得日益重要。Spring Boot 彻底改变了开发者构建应用程序的方式。借助 Spring 的编程模型以及 Spring Boot 处理的运行时职责,开发独立的、生产级的基于 Spring 的微服务变得轻而易举。
为了将其扩展到数据集成工作负载,Spring Integration 和 Spring Boot 被整合到一个新项目中。Spring Cloud Stream 由此诞生。
借助 Spring Cloud Stream,开发者能够:
-
在隔离环境中构建、测试和部署以数据为中心的应用程序。
-
应用现代微服务架构模式,包括通过消息传递进行组合。
-
采用以事件为中心的思维来解耦应用程序职责。一个事件可以表示在某个时间点发生的事情,下游消费者应用程序可以对其做出反应,而无需知道其来源或生产者的身份。
-
将业务逻辑移植到消息代理(如 RabbitMQ、Apache Kafka、Amazon Kinesis)上。
-
依赖框架对常见用例的自动内容类型支持。可以扩展到不同的数据转换类型。
-
以及更多功能……
快速开始
你可以在不到5分钟的时间内尝试Spring Cloud Stream,甚至在深入了解任何细节之前,只需按照这个三步指南操作即可。
我们将向您展示如何创建一个Spring Cloud Stream应用程序,该应用程序接收来自您选择的消息中间件(稍后会详细介绍)的消息,并将接收到的消息记录到控制台。我们称之为LoggingConsumer。虽然它并不十分实用,但它很好地介绍了其中的一些主要概念和抽象,使您更容易理解本用户指南的其余部分。
这三个步骤如下:
使用 Spring Initializr 创建示例应用程序
要开始使用,请访问 Spring Initializr。在那里,您可以生成我们的 LoggingConsumer 应用程序。具体操作如下:
-
在 Dependencies 部分,开始输入
stream。当出现“Cloud Stream”选项时,请选择它。 -
开始输入 'kafka' 或 'rabbit'。
-
选择“Kafka”或“RabbitMQ”。
本质上,您选择的是应用程序将绑定的消息中间件。我们建议使用您已经安装的,或者您觉得安装和运行起来更顺手的那个。另外,从 Initializer 的界面中您可以看到,还有其他一些选项可供选择。例如,您可以选择 Gradle 作为构建工具,而不是 Maven(默认选项)。
-
在 Artifact 字段中,输入 'logging-consumer'。
Artifact 字段的值将成为应用程序的名称。如果您为中间件选择了 RabbitMQ,您的 Spring Initializr 现在应该如下所示:
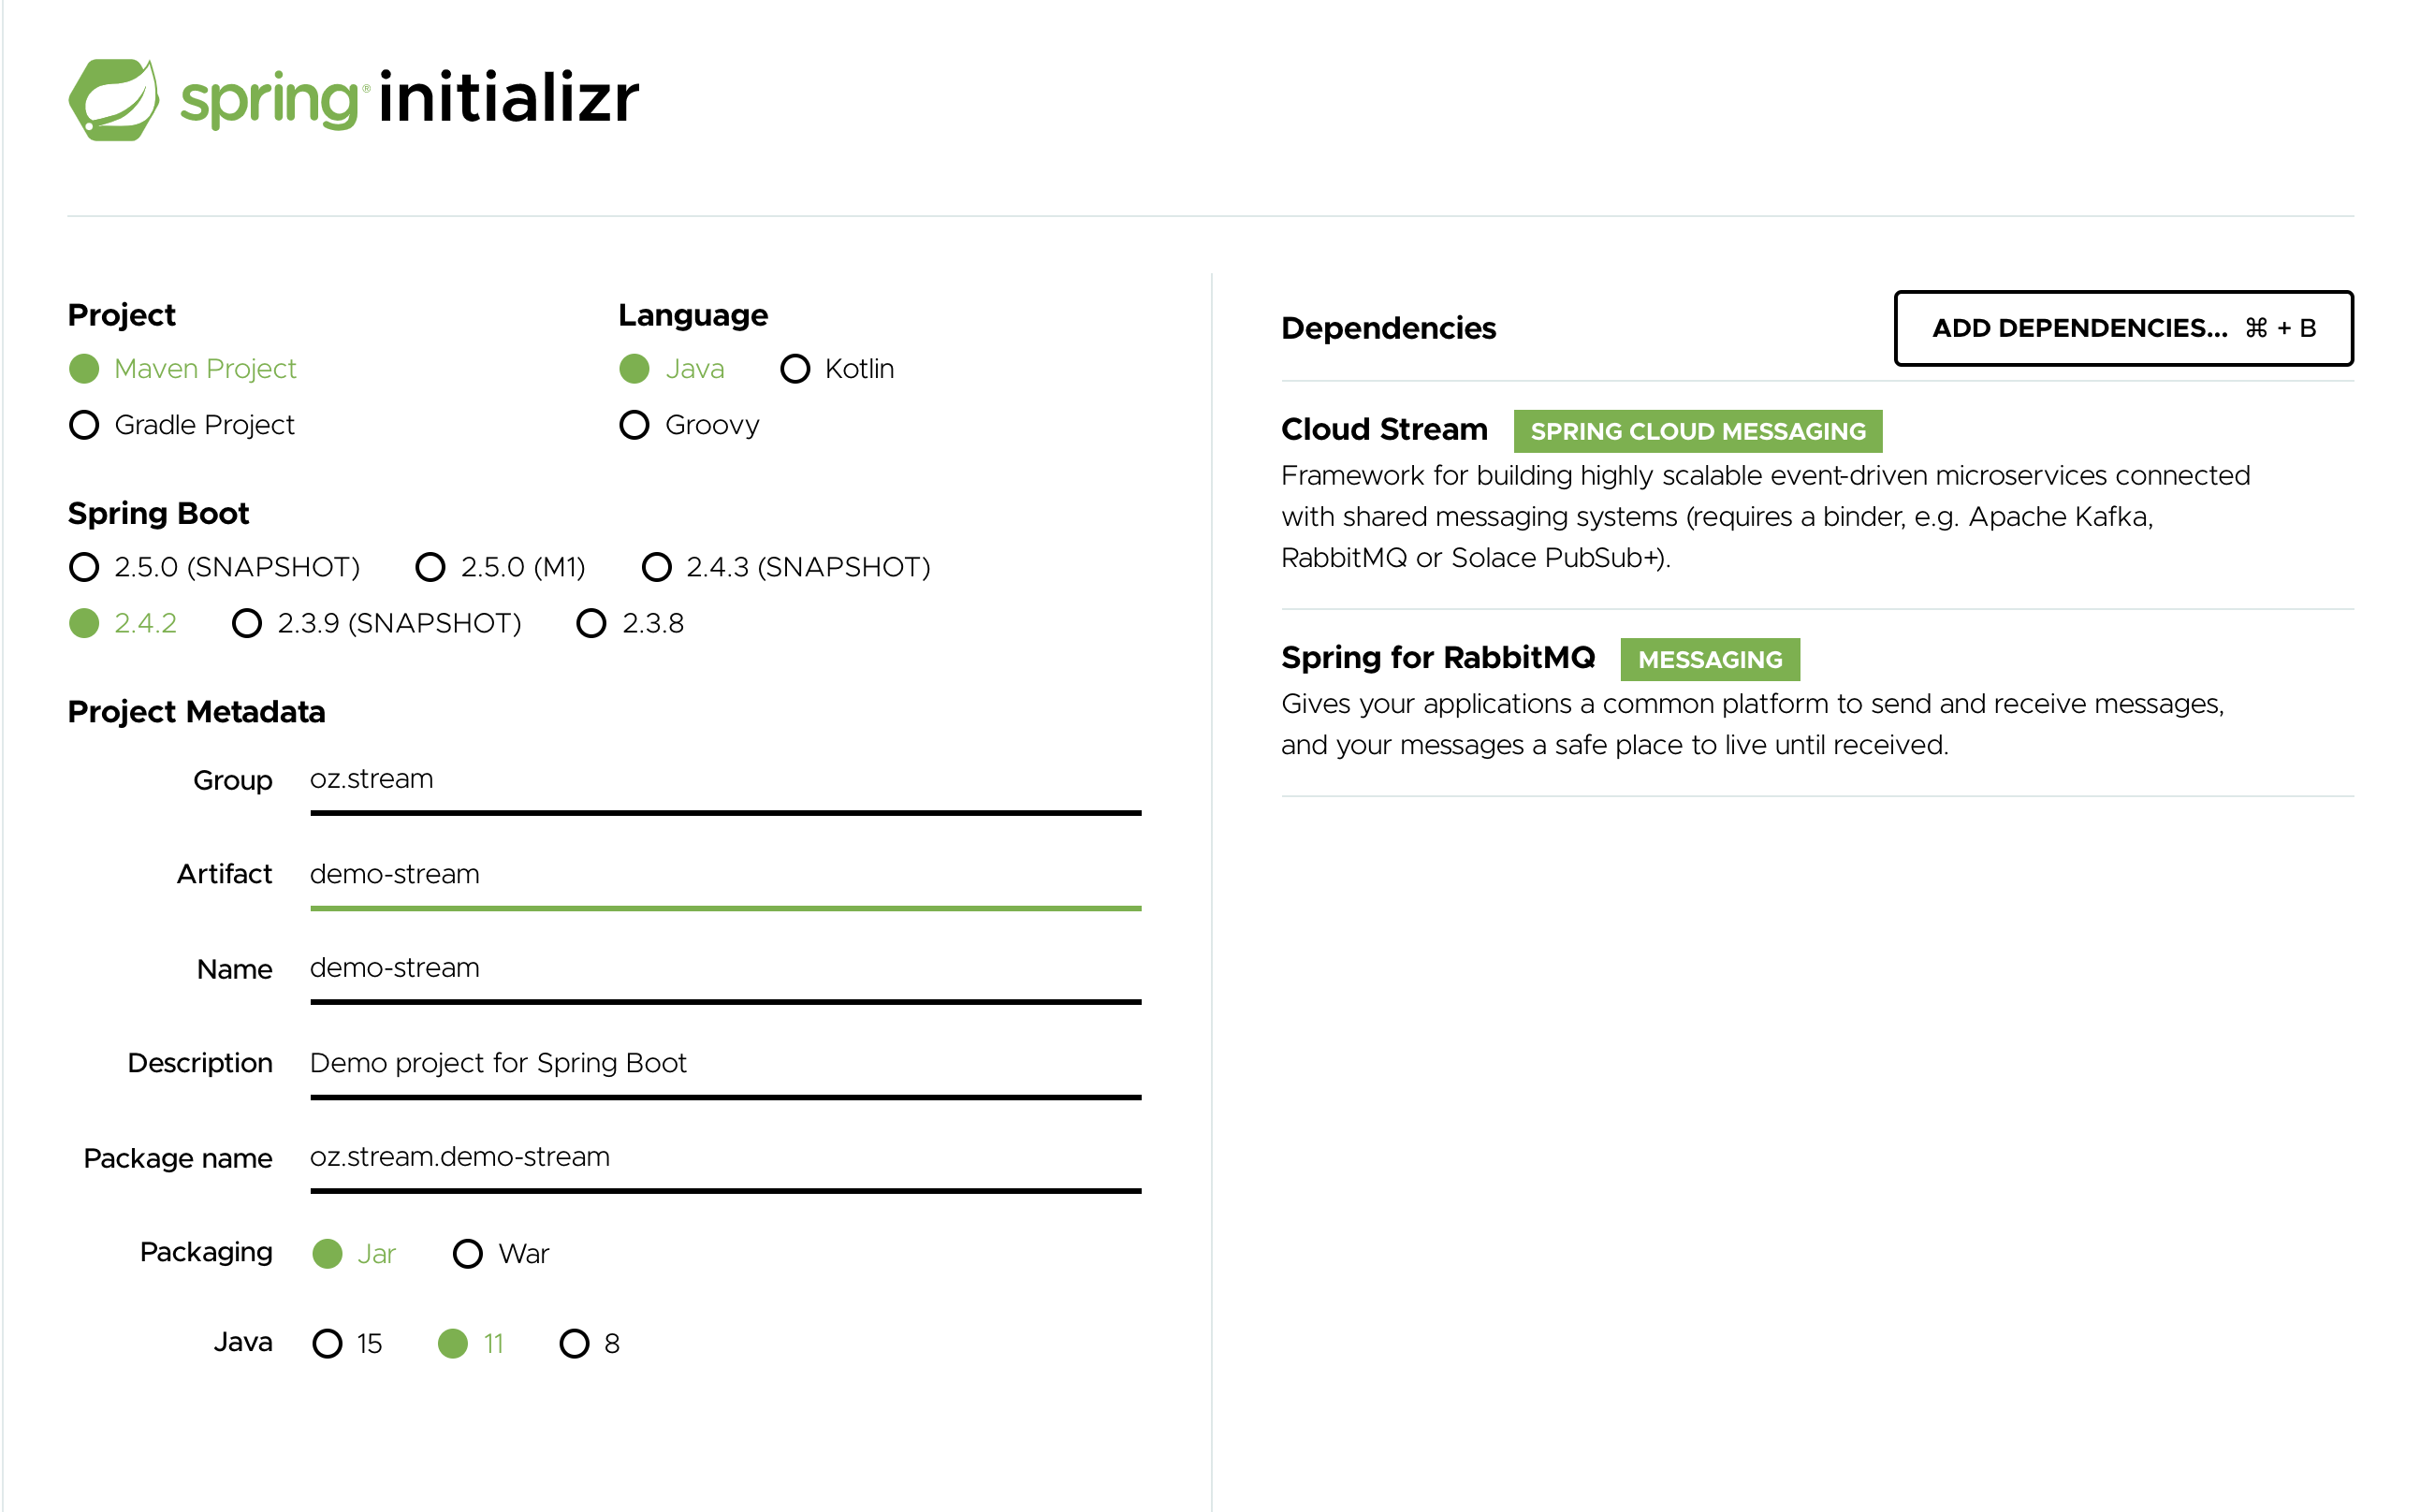
-
点击 生成项目 按钮。
这样会将生成项目的压缩版本下载到您的硬盘。
-
将文件解压到您想用作项目目录的文件夹中。
我们鼓励您探索 Spring Initializr 提供的众多可能性。它能让您创建多种不同类型的 Spring 应用程序。
将项目导入你的 IDE
现在你可以将项目导入到你的 IDE 中。请注意,根据 IDE 的不同,你可能需要遵循特定的导入流程。例如,根据项目生成方式(Maven 或 Gradle)的不同,你可能需要遵循特定的导入步骤(例如,在 Eclipse 或 STS 中,你需要使用 File → Import → Maven → Existing Maven Project)。
导入后,项目不应存在任何类型的错误。同时,src/main/java 目录下应包含 com.example.loggingconsumer.LoggingConsumerApplication。
从技术上讲,此时你可以运行应用程序的主类。它已经是一个有效的Spring Boot应用程序。然而,它目前没有任何功能,因此我们需要添加一些代码。
添加消息处理器、构建与运行
修改 com.example.loggingconsumer.LoggingConsumerApplication 类,使其内容如下:
@SpringBootApplication
public class LoggingConsumerApplication {

	public static void main(String[] args) {
		SpringApplication.run(LoggingConsumerApplication.class, args);
	}

	@Bean
	public Consumer<Person> log() {
	    return person -> {
	        System.out.println("Received: " + person);
	    };
	}

	public static class Person {
		private String name;
		public String getName() {
			return name;
		}
		public void setName(String name) {
			this.name = name;
		}
		public String toString() {
			return this.name;
		}
	}
}
从上面的代码中可以看出:
-
我们采用函数式编程模型(参见[[Spring Cloud Function支持]](#Spring Cloud Function支持)),将单个消息处理器定义为
Consumer。 -
我们依赖框架约定,将该处理器绑定到由绑定器暴露的输入目标绑定。
这样做还能让你看到该框架的一个核心特性:它会尝试自动将传入的消息负载转换为 Person 类型。
现在,你已经拥有了一个功能完整的Spring Cloud Stream应用程序,它能够监听消息。为了简化说明,我们假设你在第一步中选择了RabbitMQ。假设你已经安装并运行了RabbitMQ,可以通过在IDE中运行其main方法来启动应用程序。
你应该看到以下输出:
--- [ main] c.s.b.r.p.RabbitExchangeQueueProvisioner : declaring queue for inbound: input.anonymous.CbMIwdkJSBO1ZoPDOtHtCg, bound to: input
	--- [ main] o.s.a.r.c.CachingConnectionFactory       : Attempting to connect to: [localhost:5672]
	--- [ main] o.s.a.r.c.CachingConnectionFactory       : Created new connection: rabbitConnectionFactory#2a3a299:0/SimpleConnection@66c83fc8. . .
	. . .
	--- [ main] o.s.i.a.i.AmqpInboundChannelAdapter      : started inbound.input.anonymous.CbMIwdkJSBO1ZoPDOtHtCg
	. . .
	--- [ main] c.e.l.LoggingConsumerApplication         : Started LoggingConsumerApplication in 2.531 seconds (JVM running for 2.897)
前往 RabbitMQ 管理控制台或任何其他 RabbitMQ 客户端,向 input.anonymous.CbMIwdkJSBO1ZoPDOtHtCg 发送一条消息。anonymous.CbMIwdkJSBO1ZoPDOtHtCg 部分代表组名,是自动生成的,因此在您的环境中肯定会有所不同。为了获得更可预测的结果,您可以通过设置 spring.cloud.stream.bindings.input.group=hello(或您喜欢的任何名称)来使用显式组名。
消息内容应为 Person 类的 JSON 表示,如下所示:
{"name":"Sam Spade"}
然后,在你的控制台中,你应该看到:
Received: Sam Spade
你也可以将应用程序构建并打包成一个可启动的JAR文件(通过使用 ./mvnw clean install 命令),然后使用 java -jar 命令来运行这个构建好的JAR。
现在你已经有了一个可以运行的(尽管非常基础)Spring Cloud Stream 应用程序。
流式数据上下文中的 Spring 表达式语言 (SpEL)
在本参考手册中,您会遇到许多可以利用 Spring 表达式语言(SpEL)的功能和示例。了解使用它时的某些限制非常重要。
SpEL 让你能够访问当前消息以及你正在运行的应用程序上下文。然而,理解 SpEL 能够看到什么类型的数据非常重要,尤其是在传入消息的上下文中。从代理(broker)接收到的消息是以字节数组(byte[])的形式到达的。然后,绑定器(binders)会将其转换为 Message<byte[]>,你可以看到消息的有效负载(payload)保持其原始形式。消息的头部(headers)是 <String, Object> 类型,其中的值通常是另一个基本类型或基本类型的集合/数组,因此是 Object 类型。这是因为绑定器不知道所需的输入类型,因为它无法访问用户代码(函数)。所以,绑定器有效地传递了一个包含有效负载和一些可读元数据(以消息头部的形式)的信封,就像邮件递送的信件一样。这意味着,虽然可以访问消息的有效负载,但你只能以原始数据(即 byte[])的形式访问它。尽管开发者可能非常希望 SpEL 能够以具体类型(例如 Foo、Bar 等)访问有效负载对象的字段,但你可以看到实现这一点的难度有多大,甚至是不可能的。这里有一个例子来演示这个问题:假设你有一个路由表达式,根据有效负载类型路由到不同的函数。这个需求意味着需要将有效负载从 byte[] 转换为特定类型,然后应用 SpEL。然而,为了执行这种转换,我们需要知道传递给转换器的实际类型,而这来自函数的签名,但我们不知道是哪一个。解决这个需求的更好方法是将类型信息作为消息头部传递(例如 application/json;type=foo.bar.Baz)。你将得到一个清晰可读的字符串值,可以在一年内访问和评估,并且易于阅读 SpEL 表达式。
此外,使用有效载荷进行路由决策被认为是非常糟糕的做法,因为有效载荷被视为特权数据——只有最终接收者才能读取的数据。再次以邮件递送为例,你不会希望邮递员打开你的信封并阅读信件内容来做出某些递送决定。同样的概念在这里也适用,尤其是在生成消息时包含此类信息相对容易的情况下。这强制执行了与通过网络传输的数据设计相关的某种程度的纪律,以及哪些数据可以被视为公共的,哪些是特权的。